Voce locale in Home Assistant: l'hardware che serve davvero
 Andrea R.
La risposta breve: se il tuo Home Assistant gira su un Home Assistant Green o su un Raspberry Pi, puoi già avere un assistente vocale completamente locale per controllare la casa, con Speech-to-Phrase per il riconoscimento vocale e Piper per la risposta parlata. Serve altro hardware solo se vuoi parlare liberamente: Whisper richiede almeno un mini PC di classe Intel N100, e un LLM locale con Ollama davvero utile richiede una macchina separata con molta memoria, idealmente una GPU.
Quasi tutte le guide alla «voce locale» partono dalla lista della spesa. Questa fa il contrario: parte da ciò che hai già in casa, da ciò che quell'hardware può far girare in modo realistico e dal momento in cui un aggiornamento vale davvero la spesa. Tutti i dati di velocità riportati vengono dalla documentazione ufficiale di Home Assistant o dalla libreria di modelli di Ollama, non da nostre misurazioni.
In breve
- Speech-to-Phrase trascrive in meno di un secondo su un Home Assistant Green o un Raspberry Pi 4, e in circa 150 ms su un Raspberry Pi 5, ma conosce solo le frasi di controllo della casa.
- Whisper capisce quasi tutto, ma impiega circa 8 secondi per comando su un Raspberry Pi 4. Home Assistant raccomanda almeno un Intel N100 per il modello Base.
- Piper, la sintesi vocale locale, genera circa 1,6 secondi di voce per ogni secondo di calcolo su un Raspberry Pi con voci di qualità media.
- Un LLM locale con Ollama gira su un server separato; Home Assistant consiglia di esporgli meno di 25 entità.
- Attiva «Prefer handling commands locally» (preferisci l'elaborazione locale dei comandi): i comandi semplici restano veloci e solo il resto passa all'LLM.
La scala dell'hardware: cosa può far girare ogni macchina
Ecco la nostra lettura della documentazione ufficiale, ordinata in base al dispositivo che la maggior parte dei lettori possiede già. La colonna «configurazione realistica» è la raccomandazione di Rocks, non una classifica ufficiale.
| Il tuo server Home Assistant | Riconoscimento vocale adatto | Sintesi vocale | Agente di conversazione | Configurazione realistica |
|---|---|---|---|---|
| Home Assistant Green (Rockchip RK3566, 4 GB di RAM) | Speech-to-Phrase (meno di 1 s) | Piper | Agente integrato di Home Assistant | Controllo 100% locale; LLM solo via cloud o su una seconda macchina |
| Raspberry Pi 4 | Speech-to-Phrase (meno di 1 s); Whisper ~8 s, troppo lento | Piper | Agente integrato | Come il Green |
| Raspberry Pi 5 | Speech-to-Phrase (~150 ms) | Piper | Agente integrato | L'opzione a basso consumo più reattiva per i comandi |
| Mini PC Intel N100 o tipo Intel NUC | Whisper (modello Base, meno di 1 s su un NUC) o Speech-to-Phrase | Piper | Agente integrato; un piccolo LLM come esperimento | Parlato libero nelle lingue ben supportate |
| PC separato con GPU o tanta memoria unificata | Whisper, modelli più grandi | Piper | Ollama con un modello compatibile con i «tools» | Controllo in linguaggio naturale e domande, in locale |
Due cose saltano all'occhio. La prima: per Speech-to-Phrase il passaggio da Raspberry Pi 4 a Pi 5 conta molto più di quanto si pensi, perché secondo l'annuncio Voice chapter 9 di Home Assistant il Pi 5 elabora i comandi sette volte più in fretta. La seconda: nulla nelle prime tre righe richiede un acquisto se Home Assistant gira già su quell'hardware.
Il percorso di un comando vocale locale
Conoscere le quattro fasi aiuta a capire da dove arriva l'attesa.
- Parola di attivazione. Il satellite sente «Okay Nabu», «Hey Jarvis» o «Hey Mycroft». Sul Voice Preview Edition il rilevamento avviene sul dispositivo stesso, grazie a microWakeWord.
- Riconoscimento vocale. L'audio arriva al server Home Assistant, dove Speech-to-Phrase o Whisper lo trasformano in testo.
- Agente di conversazione. L'agente integrato associa la frase a un'azione. Facoltativamente, un LLM gestisce ciò che non capisce.
- Sintesi vocale. Piper pronuncia la risposta tramite il satellite.
I motori vocali si collegano tramite il protocollo Wyoming. Per questo puoi sostituire Whisper con Speech-to-Phrase, o farli girare su un'altra macchina, senza toccare il resto della catena.
Tre modi per trasformare la voce in testo
È la scelta che condiziona tutto il resto. Ecco le tre opzioni ufficiali a confronto.
| Opzione | Cosa capisce | Velocità (dati ufficiali) | Hardware | Costo |
|---|---|---|---|---|
| Speech-to-Phrase (locale) | Solo frasi costruite dai tuoi dispositivi, aree e modelli di frase esposti | Meno di 1 s su Green o Pi 4; ~150 ms su Pi 5 | Basta hardware modesto | Gratuito |
| Whisper (locale) | Parlato libero | ~8 s su Pi 4; meno di 1 s su un Intel NUC | Consigliato Intel N100 o superiore | Gratuito |
| Home Assistant Link (cloud) | Parlato libero, molte lingue | Non pubblicata | Qualsiasi | 7,50 €/mese o 75 €/anno in Europa secondo la pagina ufficiale consultata a ottobre |
Speech-to-Phrase: veloce perché circoscritto
Speech-to-Phrase non si chiede «cosa hai detto?», ma «quale delle frasi che conosco hai detto?». Secondo la sua pagina di progetto, combina modelli di frase predefiniti con i nomi di entità, aree e piani esposti ad Assist. Luci, luminosità, colori, meteo, timer e lettori multimediali sono coperti.
Il limite è altrettanto chiaro: tutto ciò che accetta parole libere, come aggiungere un articolo alla lista della spesa, dare un nome a un timer o inviare annunci, non funziona di serie. Home Assistant precisa anche che è pensato per il controllo della casa, non per alimentare un LLM.
Il progetto è inoltre in transizione. Il repository segnala che lo sviluppo è passato a una riscrittura nel progetto OHF-Voice apps, con un decoder diverso, che per ora supporta catalano, ceco, tedesco, inglese, spagnolo, francese, italiano e olandese.
Whisper: capisce tutto, ma è pesante
Whisper prova a trascrivere tutto. La guida ufficiale alla voce locale parla di circa 8 secondi per comando su un Raspberry Pi 4 e di meno di un secondo su un Intel NUC. Le FAQ del Voice Preview Edition raccomandano almeno un Intel N100 per il modello Base e avvertono che le lingue con meno dati di addestramento richiedono i modelli Small o Large, molto più esigenti.
Home Assistant Link: la scorciatoia dichiarata
L'opzione cloud affida il riconoscimento vocale a Microsoft Azure con condizioni commerciali; Nabu Casa afferma che né lei né Azure conservano i tuoi dati vocali. È l'unica opzione che offre il parlato libero su un Green. Il prezzo aggiornato è sulla pagina di Home Assistant Link, e l'abbonamento finanzia anche lo sviluppo di Home Assistant.
Aggiungere un LLM locale con Ollama
L'agente integrato è veloce e prevedibile, ma capisce solo le formulazioni che conosce. Un LLM può gestire «qui è troppo buio» o una domanda sulla tua casa. L'integrazione Ollama, disponibile da Home Assistant 2024.4, si collega a un server Ollama esterno su macOS, Linux o Windows. Non gira sul dispositivo Home Assistant.
La documentazione contiene diversi avvertimenti molto pratici:
- Solo i modelli che supportano gli strumenti (tools) possono controllare Home Assistant.
- Esponi meno di 25 entità quando sperimenti con gli LLM locali; i modelli piccoli sbagliano di più.
- Home Assistant imposta di default una finestra di contesto di 8k token. Una finestra più ampia aiuta nelle case grandi ma consuma più RAM sul server Ollama.
- Il controllo di Home Assistant tramite Ollama è definito sperimentale.
Quanta memoria serve a ogni modello
La libreria di modelli di Ollama riporta la dimensione di download di ogni variante. È il minimo indispensabile: il modello deve stare in memoria e la finestra di contesto ne chiede altra.
| Modello (tag Ollama) | Dimensione download | Supporto tools | Dove ha senso, secondo noi |
|---|---|---|---|
| llama3.2:3b | 2,0 GB | Sì | Esperimento su mini PC, richieste semplici |
| qwen3:4b | 2,5 GB | Sì | Esperimento su mini PC |
| qwen3:8b | 5,2 GB | Sì | GPU con almeno 8 GB di memoria |
| qwen3:14b | 9,3 GB | Sì | GPU con almeno 12 GB di memoria |
| qwen3:30b | 19 GB | Sì | GPU da 24 GB o macchina con molta memoria unificata |
Per approfondire un modello recente pensato proprio per questo compito, la nostra analisi di LFM2.5-24B-A2B come agente locale per Home Assistant spiega memoria necessaria e installazione passo dopo passo.
L'impostazione che mantiene tutto veloce
Quando scegli un LLM come agente di conversazione, attiva «Prefer handling commands locally». Home Assistant l'ha introdotta perché molti comandi facili finivano a un LLM, rallentando tutto. Con l'opzione attiva, Home Assistant prova prima il suo agente integrato e passa la richiesta all'LLM solo se non la capisce. La cronologia della conversazione è condivisa con l'LLM, quindi le domande successive mantengono il contesto.
Un dettaglio importante: Speech-to-Phrase non sa trascrivere domande libere, quindi il passaggio all'LLM ha senso solo con Whisper o con il cloud per il riconoscimento vocale.
Cosa ascolta: il satellite
Il calcolo avviene sul server; il satellite deve solo sentire bene. Le opzioni, dalla più economica alla più rifinita:
- Il tuo smartphone. L'app di Home Assistant esegue Assist, e Android può restare in ascolto di una parola di attivazione.
- Un dispositivo ESPHome da 13 $. Il tutorial ufficiale del telecomando vocale da 13 $ trasforma una piccola scheda ESP32 in un satellite con pulsante.
- Un vecchio smart speaker. Alcuni progetti della community riconvertono certi speaker Google e Amazon; vedi la nostra guida per trasformare un vecchio Echo o Google Home in uno speaker vocale per Home Assistant.
- Home Assistant Voice Preview Edition. Prezzo consigliato 59 € (69 $ negli USA), ESP32-S3, chip audio XMOS XU316 con cancellazione dell'eco, doppio microfono, un interruttore che toglie fisicamente l'alimentazione ai microfoni e uscita da 3,5 mm, secondo la pagina ufficiale del prodotto. Caricatore non incluso.
Compatibilità con Home Assistant: i nostri consigli per profilo
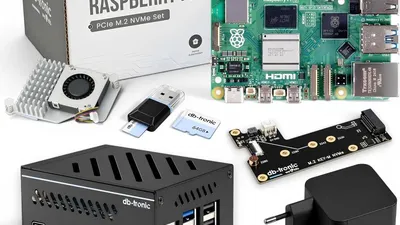
Andrea usa Home Assistant e Jellyfin sul kit Raspberry Pi 5 da 4 GB che ha recensito (recensione in inglese). Non abbiamo misurato la voce su quel dispositivo. Ma in base ai dati ufficiali, una macchina di questo tipo è il posto ideale per Speech-to-Phrase e Piper, e quello sbagliato per un LLM.
«Voglio solo accendere le luci e impostare i timer»
Resta sull'hardware che hai. Installa Speech-to-Phrase e Piper, aggiungi un satellite, esponi solo i dispositivi che comandi a voce e dai loro alias semplici. È la configurazione 100% locale più economica che esista.
«Voglio parlare in modo naturale, senza cloud»
Ti serve Whisper: metti in conto un mini PC di classe N100, come server Home Assistant o come server Wyoming separato. Se aggiungi un LLM, mettilo su un'altra macchina con GPU e lascia attiva «Prefer handling commands locally».
«Voglio che funzioni bene in italiano già da oggi»
Speech-to-Phrase supporta l'italiano. Per il parlato libero, controlla prima la tua lingua nella pagina delle lingue di Assist: Home Assistant stesso riconosce che per alcune lingue il cloud offre l'esperienza migliore, e le lingue con meno dati pubblici richiedono modelli Whisper più grandi.
Prima di installare qualsiasi cosa
Ogni motore è un'app che modifica il sistema. Fai prima un backup completo; la nostra guida a backup e ripristino di Home Assistant spiega come. La guida pilastro su Home Assistant rimanda al resto dei nostri articoli.
Domande frequenti
La voce di Home Assistant può funzionare senza internet?
Sì. Con Speech-to-Phrase o Whisper per il riconoscimento, Piper per la sintesi e l'agente di conversazione integrato, ogni passaggio gira sul tuo hardware. Solo un LLM in cloud o Home Assistant Link richiederebbero la connessione.
Un Raspberry Pi 5 basta per la voce locale?
Per controllare la casa con Speech-to-Phrase, sì: Home Assistant indica circa 150 ms per comando su un Pi 5. Per Whisper raccomanda un Intel N100 o superiore, e un LLM utile richiede una macchina separata più potente.
Serve una GPU?
Non per Speech-to-Phrase, Piper o il modello Base di Whisper su un N100. La GPU diventa utile con i modelli Whisper più grandi e per far girare in modo fluido un LLM da 8 miliardi di parametri o più.
Speech-to-Phrase può aggiungere articoli alla lista della spesa?
Non di serie. Riconosce solo le frasi che conosce, quindi i comandi con parole libere, come lista della spesa, timer con nome o annunci, richiedono Whisper o il cloud.
Firma: Andrea R., sulla base della documentazione e degli annunci ufficiali di Home Assistant sulla voce, della pagina del progetto Speech-to-Phrase, della libreria di modelli di Ollama e della sua installazione di Home Assistant su Raspberry Pi 5.
Trasparenza: Rocks on Galaxy non ha alcun legame con Nabu Casa, la Open Home Foundation o Ollama, e questo articolo non contiene link di affiliazione. Non abbiamo provato il Voice Preview Edition né effettuato misurazioni vocali; le velocità citate sono quelle dichiarate dagli editori. Prezzi e documentazione al 13 novembre 2026.
Tag :
- Home Assistant
- Assistente vocale locale
- Assist
- Speech to Phrase
- Whisper
- Piper
- Ollama
- IA locale