Voz local en Home Assistant: el hardware que realmente necesitas
 Andrea R.
La respuesta corta: si tu Home Assistant funciona en un Home Assistant Green o en una Raspberry Pi, ya puedes tener un asistente de voz totalmente local para controlar la casa, con Speech-to-Phrase para el reconocimiento de voz y Piper para la respuesta hablada. Solo necesitas más hardware si quieres hablar con libertad: Whisper pide como mínimo un mini PC de la clase Intel N100, y un LLM local con Ollama que sea realmente útil pide una máquina aparte con mucha memoria, idealmente con GPU.
Casi todos los tutoriales de «voz local» empiezan por la lista de la compra. Esta guía va al revés: qué tienes ya en casa, qué puede mover de forma realista y en qué momento una mejora compensa de verdad. Todas las cifras de velocidad salen de la documentación oficial de Home Assistant o de la biblioteca de modelos de Ollama, no de mediciones propias.
Lo esencial
- Speech-to-Phrase transcribe en menos de un segundo en un Home Assistant Green o una Raspberry Pi 4, y en unos 150 ms en una Raspberry Pi 5, pero solo conoce frases de control del hogar.
- Whisper entiende casi cualquier cosa, pero tarda unos 8 segundos por orden en una Raspberry Pi 4. Home Assistant recomienda al menos un Intel N100 para su modelo Base.
- Piper, la síntesis de voz local, genera alrededor de 1,6 segundos de voz por segundo de cálculo en una Raspberry Pi con voces de calidad media.
- Un LLM local con Ollama se ejecuta en un servidor aparte; Home Assistant aconseja exponerle menos de 25 entidades.
- Activa «Prefer handling commands locally» (preferir el procesamiento local de órdenes): las órdenes simples siguen siendo rápidas y solo el resto va al LLM.
La escalera de hardware: qué puede mover cada equipo
Esta es nuestra lectura de la documentación oficial, ordenada según el equipo que la mayoría de lectores ya tiene. La columna «montaje realista» es la recomendación de Rocks, no una clasificación oficial.
| Tu servidor Home Assistant | Reconocimiento de voz adecuado | Síntesis de voz | Agente de conversación | Montaje realista |
|---|---|---|---|---|
| Home Assistant Green (Rockchip RK3566, 4 GB de RAM) | Speech-to-Phrase (menos de 1 s) | Piper | Agente integrado de Home Assistant | Control 100 % local; LLM solo en la nube o en una segunda máquina |
| Raspberry Pi 4 | Speech-to-Phrase (menos de 1 s); Whisper ~8 s, demasiado lento | Piper | Agente integrado | Igual que el Green |
| Raspberry Pi 5 | Speech-to-Phrase (~150 ms) | Piper | Agente integrado | La opción de bajo consumo más ágil para órdenes |
| Mini PC Intel N100 o tipo Intel NUC | Whisper (modelo Base, menos de 1 s en un NUC) o Speech-to-Phrase | Piper | Agente integrado; un LLM pequeño como prueba | Habla libre en idiomas bien soportados |
| PC aparte con GPU o mucha memoria unificada | Whisper, modelos más grandes | Piper | Ollama con un modelo compatible con «tools» | Control en lenguaje natural y preguntas, en local |
Destacan dos cosas. Primero, el salto de una Raspberry Pi 4 a una Pi 5 importa mucho más de lo que parece con Speech-to-Phrase: el anuncio Voice chapter 9 de Home Assistant dice que la Pi 5 procesa las órdenes siete veces más rápido. Segundo, nada de las tres primeras filas obliga a comprar nada si Home Assistant ya funciona en ese equipo.
El recorrido de una orden de voz local
Conocer las cuatro etapas ayuda a entender de dónde sale la espera.
- Palabra de activación. El satélite oye «Okay Nabu», «Hey Jarvis» o «Hey Mycroft». En el Voice Preview Edition, esta detección se hace en el propio dispositivo con microWakeWord.
- Reconocimiento de voz. El audio viaja a tu servidor Home Assistant, donde Speech-to-Phrase o Whisper lo convierten en texto.
- Agente de conversación. El agente integrado asocia la frase a una acción. Opcionalmente, un LLM se ocupa de lo que no entiende.
- Síntesis de voz. Piper pronuncia la respuesta a través del satélite.
Los motores de voz se conectan mediante el protocolo Wyoming. Por eso puedes cambiar Whisper por Speech-to-Phrase, o ejecutar cualquiera de ellos en otra máquina, sin tocar el resto de la cadena.
Tres formas de convertir la voz en texto
Es la decisión que condiciona todo lo demás. Estas son las tres opciones oficiales, una al lado de la otra.
| Opción | Qué entiende | Velocidad (cifras oficiales) | Hardware | Coste |
|---|---|---|---|---|
| Speech-to-Phrase (local) | Solo frases creadas a partir de tus dispositivos, áreas y plantillas expuestos | Menos de 1 s en Green o Pi 4; ~150 ms en Pi 5 | Basta con un equipo modesto | Gratis |
| Whisper (local) | Habla libre | ~8 s en Pi 4; menos de 1 s en un Intel NUC | Se recomienda Intel N100 o superior | Gratis |
| Home Assistant Link (nube) | Habla libre, muchos idiomas | No publicada | Cualquiera | 7,50 €/mes o 75 €/año en Europa según la página oficial consultada en octubre |
Speech-to-Phrase: rápido porque es acotado
Speech-to-Phrase no se pregunta «¿qué has dicho?», sino «¿cuál de las frases que conozco has dicho?». Según su página del proyecto, combina plantillas de frases predefinidas con los nombres de las entidades, áreas y plantas expuestas a Assist. Luces, brillo, colores, tiempo, temporizadores y reproductores multimedia están cubiertos.
El límite es igual de claro: todo lo que acepta palabras libres, como añadir algo a la lista de la compra, poner nombre a un temporizador o enviar avisos, no funciona de serie. Home Assistant también aclara que está pensado para el control del hogar, no para alimentar un LLM.
Además, está en plena transición. El repositorio indica que el desarrollo se ha trasladado a una reescritura dentro del proyecto OHF-Voice apps, con otro decodificador, que por ahora da servicio en catalán, checo, alemán, inglés, español, francés, italiano y neerlandés.
Whisper: lo entiende todo, pero pesa
Whisper intenta transcribirlo todo. La guía oficial de voz local lo sitúa en unos 8 segundos por orden en una Raspberry Pi 4 y por debajo de un segundo en un Intel NUC. Las preguntas frecuentes del Voice Preview Edition recomiendan al menos un Intel N100 para el modelo Base, y avisan de que los idiomas con menos datos de entrenamiento necesitan los modelos Small o Large, mucho más exigentes. El español, por suerte, figura entre los idiomas con grandes conjuntos de datos públicos que Home Assistant cita como buenos candidatos para el modelo Base.
Home Assistant Link: el atajo sin complejos
La opción en la nube envía el reconocimiento de voz a Microsoft Azure con condiciones comerciales; Nabu Casa asegura que ni ella ni Azure guardan tus datos de voz. Es la única opción que ofrece habla libre en un Green. El precio actualizado está en la página de Home Assistant Link, y la suscripción también financia el desarrollo de Home Assistant.
Añadir un LLM local con Ollama
El agente integrado es rápido y predecible, pero solo entiende las formulaciones que conoce. Un LLM puede resolver «aquí está demasiado oscuro» o una pregunta sobre tu casa. La integración de Ollama, disponible desde Home Assistant 2024.4, se conecta a un servidor Ollama externo en macOS, Linux o Windows. No se ejecuta en el propio equipo de Home Assistant.
La documentación incluye varios avisos muy prácticos:
- Solo los modelos compatibles con herramientas (tools) pueden controlar Home Assistant.
- Expón menos de 25 entidades cuando experimentes con LLM locales; los modelos pequeños se equivocan más.
- Home Assistant usa por defecto una ventana de contexto de 8k tokens. Una ventana mayor ayuda en casas grandes, pero consume más RAM en el servidor Ollama.
- El control de Home Assistant a través de Ollama se considera experimental.
Cuánta memoria necesita cada modelo
La biblioteca de modelos de Ollama muestra el tamaño de descarga de cada variante. Es el mínimo: el modelo tiene que caber en memoria y la ventana de contexto pide algo más.
| Modelo (etiqueta Ollama) | Tamaño de descarga | Compatible con tools | Dónde encaja, en nuestra opinión |
|---|---|---|---|
| llama3.2:3b | 2,0 GB | Sí | Prueba en mini PC, peticiones sencillas |
| qwen3:4b | 2,5 GB | Sí | Prueba en mini PC |
| qwen3:8b | 5,2 GB | Sí | GPU con 8 GB de memoria o más |
| qwen3:14b | 9,3 GB | Sí | GPU con 12 GB de memoria o más |
| qwen3:30b | 19 GB | Sí | GPU de 24 GB o equipo con mucha memoria unificada |
Si quieres profundizar en un modelo reciente diseñado para esta tarea, nuestro análisis de LFM2.5-24B-A2B como agente local de Home Assistant repasa la memoria necesaria y la instalación paso a paso.
El ajuste que lo mantiene rápido
Cuando elijas un LLM como agente de conversación, activa «Prefer handling commands locally». Home Assistant lo añadió porque muchas órdenes fáciles acababan en un LLM, lo que ralentizaba todo. Con él activo, Home Assistant prueba primero su agente integrado y solo pasa la petición al LLM si no la entiende. El historial de la conversación se comparte con el LLM, así que las preguntas de seguimiento siguen teniendo sentido.
Un matiz: Speech-to-Phrase no puede transcribir preguntas libres, así que el paso al LLM solo tiene sentido con Whisper o con la nube para el reconocimiento de voz.
Lo que escucha: el satélite
El cálculo se hace en el servidor; el satélite solo tiene que oír bien. Las opciones, de la más barata a la más pulida:
- Tu móvil. La app de Home Assistant ejecuta Assist, y Android puede escuchar una palabra de activación.
- Un dispositivo ESPHome de 13 $. El tutorial oficial del mando de voz de 13 $ convierte una pequeña placa ESP32 en un satélite de pulsar para hablar.
- Un altavoz inteligente antiguo. Hay proyectos de la comunidad que reconvierten algunos altavoces de Google y Amazon; consulta nuestra guía para convertir un viejo Echo o Google Home en altavoz de voz para Home Assistant.
- Home Assistant Voice Preview Edition. Precio recomendado de 59 € (69 $ en EE. UU.), ESP32-S3, chip de audio XMOS XU316 con cancelación de eco, dos micrófonos, un interruptor que corta físicamente la alimentación de los micrófonos y salida de 3,5 mm, según la página oficial del producto. No incluye cargador.
Compatibilidad con Home Assistant: nuestras recomendaciones por perfil
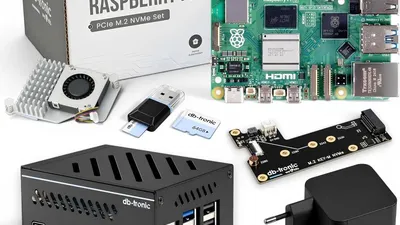
Andrea usa Home Assistant y Jellyfin en el kit Raspberry Pi 5 de 4 GB que analizó (reseña en inglés). No hemos medido la voz en él. Pero, según las cifras oficiales, ese tipo de equipo es el lugar ideal para Speech-to-Phrase y Piper, y el sitio equivocado para un LLM.
«Solo quiero encender luces y poner temporizadores»
Quédate con tu hardware actual. Instala Speech-to-Phrase y Piper, añade un satélite, expón solo los dispositivos que controlas por voz y dales alias sencillos. Es el montaje 100 % local más barato que existe.
«Quiero hablar con naturalidad y sin nube»
Necesitas Whisper: cuenta con un mini PC de la clase N100, como servidor de Home Assistant o como servidor Wyoming aparte. Si añades un LLM, ponlo en otra máquina con GPU y deja activado «Prefer handling commands locally».
«Quiero que funcione bien en español desde hoy»
Speech-to-Phrase es compatible con el español. Para el habla libre, comprueba antes tu idioma en la página de idiomas de Assist; Home Assistant reconoce que, para algunos idiomas, la nube ofrece la mejor experiencia.
Antes de instalar nada
Cada motor es una aplicación que modifica tu sistema. Haz antes una copia de seguridad completa; nuestra guía de copias de seguridad y restauración de Home Assistant explica cómo. La guía pilar de Home Assistant enlaza con el resto de nuestra cobertura.
Preguntas frecuentes
¿Puede funcionar la voz de Home Assistant sin internet?
Sí. Con Speech-to-Phrase o Whisper para el reconocimiento, Piper para la síntesis y el agente de conversación integrado, cada paso se ejecuta en tu hardware. Solo un LLM en la nube o Home Assistant Link necesitarían conexión.
¿Basta una Raspberry Pi 5 para la voz local?
Para controlar la casa con Speech-to-Phrase, sí: Home Assistant cita unos 150 ms por orden en una Pi 5. Para Whisper recomienda un Intel N100 o superior, y un LLM útil exige una máquina aparte más potente.
¿Hace falta una GPU?
No para Speech-to-Phrase, Piper o el modelo Base de Whisper en un N100. La GPU cobra sentido con los modelos grandes de Whisper y para mover con soltura un LLM de 8.000 millones de parámetros o más.
¿Puede Speech-to-Phrase añadir cosas a mi lista de la compra?
No de serie. Solo reconoce las frases que conoce, así que las órdenes con palabras libres, como la lista de la compra, los temporizadores con nombre o los avisos, necesitan Whisper o la nube.
Firma: Andrea R., a partir de la documentación y los anuncios oficiales de Home Assistant sobre voz, la página del proyecto Speech-to-Phrase, la biblioteca de modelos de Ollama y su propia instalación de Home Assistant en una Raspberry Pi 5.
Transparencia: Rocks on Galaxy no tiene ninguna relación con Nabu Casa, la Open Home Foundation ni Ollama, y este artículo no contiene enlaces de afiliación. No hemos probado el Voice Preview Edition ni hecho mediciones de voz; las velocidades citadas son las de los editores. Precios y documentación a 13 de noviembre de 2026.
Etiquetas :
- Home Assistant
- Asistente de voz local
- Assist
- Speech to Phrase
- Whisper
- Piper
- Ollama
- IA local