Assistant vocal local Home Assistant : de quel matériel avez-vous besoin ?
 Andrea R.
La réponse courte : si votre Home Assistant tourne sur un Home Assistant Green ou un Raspberry Pi, vous pouvez déjà avoir un assistant vocal 100 % local pour piloter la maison, avec Speech-to-Phrase pour la reconnaissance vocale et Piper pour la réponse parlée. Il ne faut plus de matériel que si vous voulez parler librement : Whisper demande au minimum un mini-PC de classe Intel N100, et un LLM local via Ollama réellement utile demande une machine séparée avec beaucoup de mémoire, idéalement un GPU.
La plupart des tutoriels « voix locale » commencent par la liste de courses. Ce guide part dans l'autre sens : ce que vous possédez déjà, ce que ce matériel peut raisonnablement faire tourner, et à partir de quand une mise à niveau vaut vraiment le coup. Tous les chiffres de vitesse ci-dessous viennent de la documentation officielle de Home Assistant ou de la bibliothèque de modèles d'Ollama, pas de nos propres mesures.
Ce qu'il faut retenir
- Speech-to-Phrase transcrit en moins d'une seconde sur un Home Assistant Green ou un Raspberry Pi 4, et en 150 ms environ sur un Raspberry Pi 5, mais ne connaît que les phrases de pilotage de la maison.
- Whisper comprend presque tout, mais met environ 8 secondes par commande sur un Raspberry Pi 4. Home Assistant recommande au moins un Intel N100 pour son modèle Base.
- Piper, la synthèse vocale locale, produit environ 1,6 seconde de voix par seconde de calcul sur un Raspberry Pi avec des voix de qualité moyenne.
- Un LLM local via Ollama tourne sur un serveur à part ; Home Assistant conseille de lui exposer moins de 25 entités.
- Activez « Préférer le traitement local des commandes » (Prefer handling commands locally) : les ordres simples restent rapides, seul le reste part vers le LLM.
L'échelle matérielle : ce que chaque machine peut faire tourner
Voici notre lecture de la documentation officielle, classée selon la box que la plupart des lecteurs ont déjà. La colonne « configuration réaliste » est la recommandation de Rocks, pas un classement officiel.
| Votre serveur Home Assistant | Reconnaissance vocale adaptée | Synthèse vocale | Agent de conversation | Configuration réaliste |
|---|---|---|---|---|
| Home Assistant Green (Rockchip RK3566, 4 Go de RAM) | Speech-to-Phrase (moins d'1 s) | Piper | Agent intégré de Home Assistant | Pilotage 100 % local ; LLM seulement via le cloud ou une 2e machine |
| Raspberry Pi 4 | Speech-to-Phrase (moins d'1 s) ; Whisper ~8 s, trop lent | Piper | Agent intégré | Identique au Green |
| Raspberry Pi 5 | Speech-to-Phrase (~150 ms) | Piper | Agent intégré | L'option basse consommation la plus réactive pour les commandes |
| Mini-PC Intel N100 ou de type Intel NUC | Whisper (modèle Base, moins d'1 s sur un NUC) ou Speech-to-Phrase | Piper | Agent intégré ; petit LLM à titre d'essai | Parole libre dans les langues bien prises en charge |
| PC séparé avec GPU ou beaucoup de mémoire unifiée | Whisper, modèles plus gros | Piper | Ollama avec un modèle compatible « tools » | Pilotage en langage naturel et questions, en local |
Deux choses ressortent. D'abord, l'écart entre un Raspberry Pi 4 et un Pi 5 compte bien plus qu'on ne le croit pour Speech-to-Phrase : l'annonce Voice chapter 9 de Home Assistant indique que le Pi 5 traite les commandes sept fois plus vite. Ensuite, rien dans les trois premières lignes n'exige d'acheter quoi que ce soit si Home Assistant tourne déjà sur ce matériel.
Le trajet d'une commande vocale locale
Connaître les quatre étapes aide à comprendre d'où vient l'attente.
- Mot d'activation. Le satellite entend « Okay Nabu », « Hey Jarvis » ou « Hey Mycroft ». Sur le Voice Preview Edition, cette détection tourne sur l'appareil lui-même grâce à microWakeWord.
- Reconnaissance vocale. L'audio part vers votre serveur Home Assistant, où Speech-to-Phrase ou Whisper le transforme en texte.
- Agent de conversation. L'agent intégré associe la phrase à une action. En option, un LLM prend en charge ce qu'il ne comprend pas.
- Synthèse vocale. Piper prononce la réponse via le satellite.
Les moteurs vocaux se branchent via le protocole Wyoming. C'est pour cela qu'on peut remplacer Whisper par Speech-to-Phrase, ou faire tourner l'un d'eux sur une autre machine, sans toucher au reste de la chaîne.
Trois façons de transformer la voix en texte
C'est le choix qui conditionne tout le reste. Voici les trois options officielles côte à côte.
| Option | Ce qu'elle comprend | Vitesse (chiffres officiels) | Matériel | Coût |
|---|---|---|---|---|
| Speech-to-Phrase (local) | Uniquement les phrases construites à partir de vos appareils, pièces et modèles de phrases exposés | Moins d'1 s sur Green ou Pi 4 ; ~150 ms sur Pi 5 | Un matériel modeste suffit | Gratuit |
| Whisper (local) | La parole libre | ~8 s sur Pi 4 ; moins d'1 s sur un Intel NUC | Intel N100 ou mieux recommandé | Gratuit |
| Home Assistant Link (cloud) | La parole libre, de nombreuses langues | Non publiée | N'importe lequel | 7,50 €/mois ou 75 €/an en Europe d'après la page officielle consultée en octobre |
Speech-to-Phrase : rapide parce que limité
Speech-to-Phrase ne se demande pas « qu'avez-vous dit ? » mais « laquelle des phrases que je connais avez-vous dite ? ». D'après sa page projet, il combine des modèles de phrases prédéfinis avec les noms des entités, pièces et étages exposés à Assist. Lumières, luminosité, couleurs, météo, minuteurs et lecteurs multimédias sont couverts.
La limite est tout aussi nette : tout ce qui accepte des mots libres, comme ajouter un article à la liste de courses, nommer un minuteur ou diffuser un message, ne fonctionne pas d'origine. Home Assistant précise aussi qu'il est conçu pour piloter la maison, pas pour alimenter un LLM.
Le projet est par ailleurs en transition. Le dépôt indique que le développement a migré vers une réécriture dans le projet OHF-Voice apps, avec un autre décodeur ; elle prend en charge pour l'instant le catalan, le tchèque, l'allemand, l'anglais, l'espagnol, le français, l'italien et le néerlandais.
Whisper : tout comprendre, mais à quel prix
Whisper essaie de tout transcrire. Le guide officiel de la voix locale l'estime à environ 8 secondes par commande sur un Raspberry Pi 4 et moins d'une seconde sur un Intel NUC. La FAQ du Voice Preview Edition recommande au moins un Intel N100 pour le modèle Base, et prévient que les langues moins dotées en données d'entraînement demandent les modèles Small ou Large, beaucoup plus gourmands.
Home Assistant Link : le raccourci assumé
L'option cloud confie la reconnaissance vocale à Microsoft Azure, sous conditions commerciales ; Nabu Casa affirme que ni lui ni Azure ne conservent vos données vocales. C'est la seule option qui offre la parole libre sur un Green. Le tarif à jour figure sur la page Home Assistant Link, et l'abonnement finance aussi le développement de Home Assistant.
Ajouter un LLM local avec Ollama
L'agent intégré est rapide et prévisible, mais il ne comprend que les tournures qu'on lui a apprises. Un LLM peut gérer « il fait trop sombre ici » ou une question sur votre maison. L'intégration Ollama, disponible depuis Home Assistant 2024.4, se connecte à un serveur Ollama externe sous macOS, Linux ou Windows. Elle ne tourne pas sur la box Home Assistant elle-même.
La documentation donne plusieurs avertissements très concrets :
- Seuls les modèles compatibles avec les outils (tools) peuvent piloter Home Assistant.
- Exposez moins de 25 entités pour vos essais avec un LLM local ; les petits modèles se trompent davantage.
- Home Assistant fixe par défaut une fenêtre de contexte de 8k tokens. Une fenêtre plus large aide les grandes maisons mais consomme plus de RAM sur le serveur Ollama.
- Le pilotage de Home Assistant via Ollama est qualifié d'expérimental.
Quelle mémoire pour quel modèle ?
La bibliothèque de modèles d'Ollama affiche la taille de téléchargement de chaque variante. C'est un plancher : le modèle doit tenir en mémoire, et la fenêtre de contexte en demande davantage.
| Modèle (tag Ollama) | Taille de téléchargement | Compatible tools | Où il a sa place, selon nous |
|---|---|---|---|
| llama3.2:3b | 2,0 Go | Oui | Essai sur mini-PC, demandes simples |
| qwen3:4b | 2,5 Go | Oui | Essai sur mini-PC |
| qwen3:8b | 5,2 Go | Oui | GPU avec 8 Go de mémoire ou plus |
| qwen3:14b | 9,3 Go | Oui | GPU avec 12 Go de mémoire ou plus |
| qwen3:30b | 19 Go | Oui | GPU de 24 Go ou machine à grande mémoire unifiée |
Pour un regard approfondi sur un modèle récent pensé pour ce rôle, notre analyse de LFM2.5-24B-A2B comme agent local pour Home Assistant détaille la mémoire nécessaire et l'installation pas à pas.
Le réglage qui garde tout rapide
Quand vous choisissez un LLM comme agent de conversation, activez « Préférer le traitement local des commandes ». Home Assistant l'a ajouté parce que beaucoup d'ordres simples partaient vers un LLM, ce qui ralentissait tout. Une fois activé, Home Assistant essaie d'abord son agent intégré et ne transmet la demande au LLM que s'il ne la comprend pas. L'historique de la conversation est partagé avec le LLM, donc les questions de suivi gardent leur sens.
Attention : Speech-to-Phrase ne sait pas transcrire une question libre. Le relais vers un LLM n'a donc de sens qu'avec Whisper ou le cloud pour la reconnaissance vocale.
Ce qui écoute : le satellite
Le calcul se fait sur le serveur ; le satellite doit seulement bien entendre. Les options, de la moins chère à la plus aboutie :
- Votre téléphone. L'application Home Assistant fait tourner Assist, et Android peut écouter un mot d'activation.
- Un module ESPHome à 13 $. Le tutoriel officiel de télécommande vocale à 13 $ transforme une petite carte ESP32 en satellite à bouton.
- Une vieille enceinte connectée. Des projets communautaires convertissent certaines enceintes Google et Amazon ; voir notre guide pour transformer un vieil Echo ou Google Home en enceinte vocale Home Assistant.
- Home Assistant Voice Preview Edition. Prix conseillé de 59 € (69 $ aux États-Unis), ESP32-S3, puce audio XMOS XU316 avec annulation d'écho, deux micros, interrupteur qui coupe physiquement l'alimentation des micros et sortie jack 3,5 mm, selon la page produit officielle. Pas de chargeur dans la boîte.
Pour qui ? Nos recommandations par profil
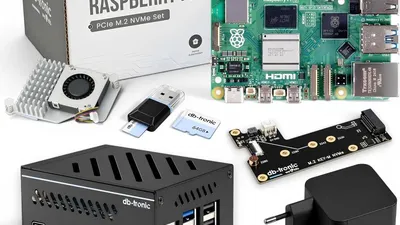
Andrea fait tourner Home Assistant et Jellyfin sur le kit Raspberry Pi 5 4 Go qu'il a testé. Nous n'y avons pas mesuré la voix. Mais d'après les chiffres officiels, ce type de box est l'endroit idéal pour Speech-to-Phrase et Piper, et le mauvais endroit pour un LLM.
« Je veux juste allumer la lumière et lancer des minuteurs »
Restez sur votre matériel actuel. Installez Speech-to-Phrase et Piper, ajoutez un satellite, n'exposez que les appareils que vous commandez à la voix et donnez-leur des alias simples. C'est la configuration 100 % locale la moins chère qui existe.
« Je veux parler naturellement, sans cloud »
Il vous faut Whisper : prévoyez un mini-PC de classe N100, comme serveur Home Assistant ou comme serveur Wyoming séparé. Pour ajouter un LLM, placez-le sur une autre machine équipée d'un GPU et laissez « Préférer le traitement local des commandes » activé.
« Je veux que ça marche bien en français dès aujourd'hui »
Speech-to-Phrase prend en charge le français. Pour la parole libre, vérifiez d'abord votre langue sur la page des langues d'Assist : le modèle Base de Whisper s'en sort bien avec les langues disposant de gros jeux de données publics, et Home Assistant reconnaît lui-même que le cloud offre la meilleure expérience pour certaines langues.
Avant d'installer quoi que ce soit
Chaque moteur est une application qui modifie votre système. Faites d'abord une sauvegarde complète ; notre guide des sauvegardes et de la restauration Home Assistant explique comment. Le guide pilier Home Assistant renvoie vers le reste de nos articles. Et si vous hésitez encore sur la plateforme, notre test du Homey Pro montre l'alternative clé en main.
FAQ
La voix de Home Assistant peut-elle fonctionner sans aucune connexion internet ?
Oui. Avec Speech-to-Phrase ou Whisper pour la reconnaissance, Piper pour la synthèse et l'agent de conversation intégré, chaque étape tourne sur votre matériel. Seuls un LLM dans le cloud ou Home Assistant Link auraient besoin d'internet.
Un Raspberry Pi 5 suffit-il pour la voix locale ?
Pour piloter la maison avec Speech-to-Phrase, oui : Home Assistant annonce environ 150 ms par commande sur un Pi 5. Pour Whisper, Home Assistant recommande un Intel N100 ou mieux, et un LLM utile demande une machine séparée plus puissante.
Faut-il un GPU ?
Pas pour Speech-to-Phrase, Piper ou le modèle Base de Whisper sur un N100. Un GPU devient pertinent pour les gros modèles Whisper et pour faire tourner confortablement un LLM de 8 milliards de paramètres ou plus.
Speech-to-Phrase peut-il ajouter des articles à ma liste de courses ?
Pas d'origine. Il ne reconnaît que les phrases qu'il connaît : les commandes qui prennent des mots libres, comme la liste de courses, les minuteurs nommés ou les annonces, demandent Whisper ou le cloud.
Signature : Andrea R., d'après la documentation et les annonces officielles de Home Assistant sur la voix, la page du projet Speech-to-Phrase, la bibliothèque de modèles d'Ollama et sa propre installation Home Assistant sur Raspberry Pi 5.
Transparence : Rocks on Galaxy n'a aucun lien avec Nabu Casa, l'Open Home Foundation ou Ollama, et cet article ne contient aucun lien commissionné. Nous n'avons pas testé le Voice Preview Edition ni mesuré les performances vocales ; les vitesses citées sont celles des éditeurs. Prix et documentation au 13 novembre 2026.
Tags :
- Home Assistant
- Assistant vocal local
- Assist
- Speech to Phrase
- Whisper
- Piper
- Ollama
- IA locale