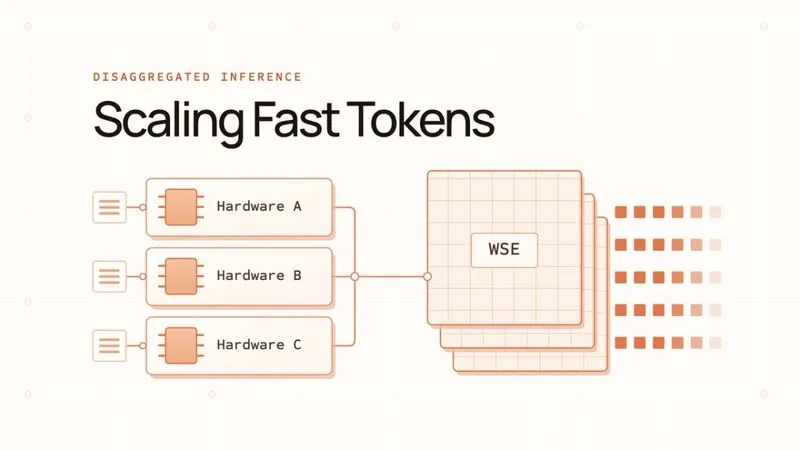
Cerebras rivendica 5× di throughput di inferenza con disaggregazione
- News
- Rocks on Galaxy
- Tech
- 04 Oct, 2026
- 1
Più token Cerebras senza comprare più wafer. Il 1° ottobre 2026, Unite.AI ha riassunto il blog Cerebras Disaggregated Inference From The Ground Up: test precoci di disaggregazione eterogenea hanno alzato il throughput di inferenza di 5× con lo stesso numero di sistemi Cerebras e senza perdita di velocità di generazione.
Prefill vs decode
Il prefill elabora l’intero prompt in parallelo (compute-bound). Il decode emette token uno alla volta con la cache KV (memory-bound). Separare le fasi su pool distinti permette di dimensionare e prioritizzare ciascuna—al costo del trasferimento della cache KV.
Twist eterogeneo
- Decode sui sistemi WSE Cerebras
- Prefill su accelerator partner (diagramma: AWS Trainium, AMD Helios Instinct…)
- Picco pubblicato (10 set. 2026): SRAM on-chip WSE-3 a 21.000 TB/s per wafer
- Artificial Analysis 10 set. 2026: Cerebras a 1.669 token/s in uscita su GPT-oss-120B (high reasoning, 10k input)
In serving aggregato un prefill grosso può frenare il decode; il batching alza il throughput globale ma può rallentare ogni utente. Cerebras contrappone la SRAM wafer-scale alle GPU via HBM. Prossimi post: stack ed economia a scala.
Verdetto Rocks
Risultati precoci vendor, PR: il 5× è un test interno, non un bake-off indipendente. Fonte: Unite.AI 1° ott.
FAQ
5× = token 5× più veloci per l’utente? Cerebras parla di capacità di throughput a impronta WSE uguale e velocità di generazione invariata.
21.000 TB/s misurati in serving? No—picco pubblicato SRAM on-chip.